
배포가 가려 주던 메모리 누수
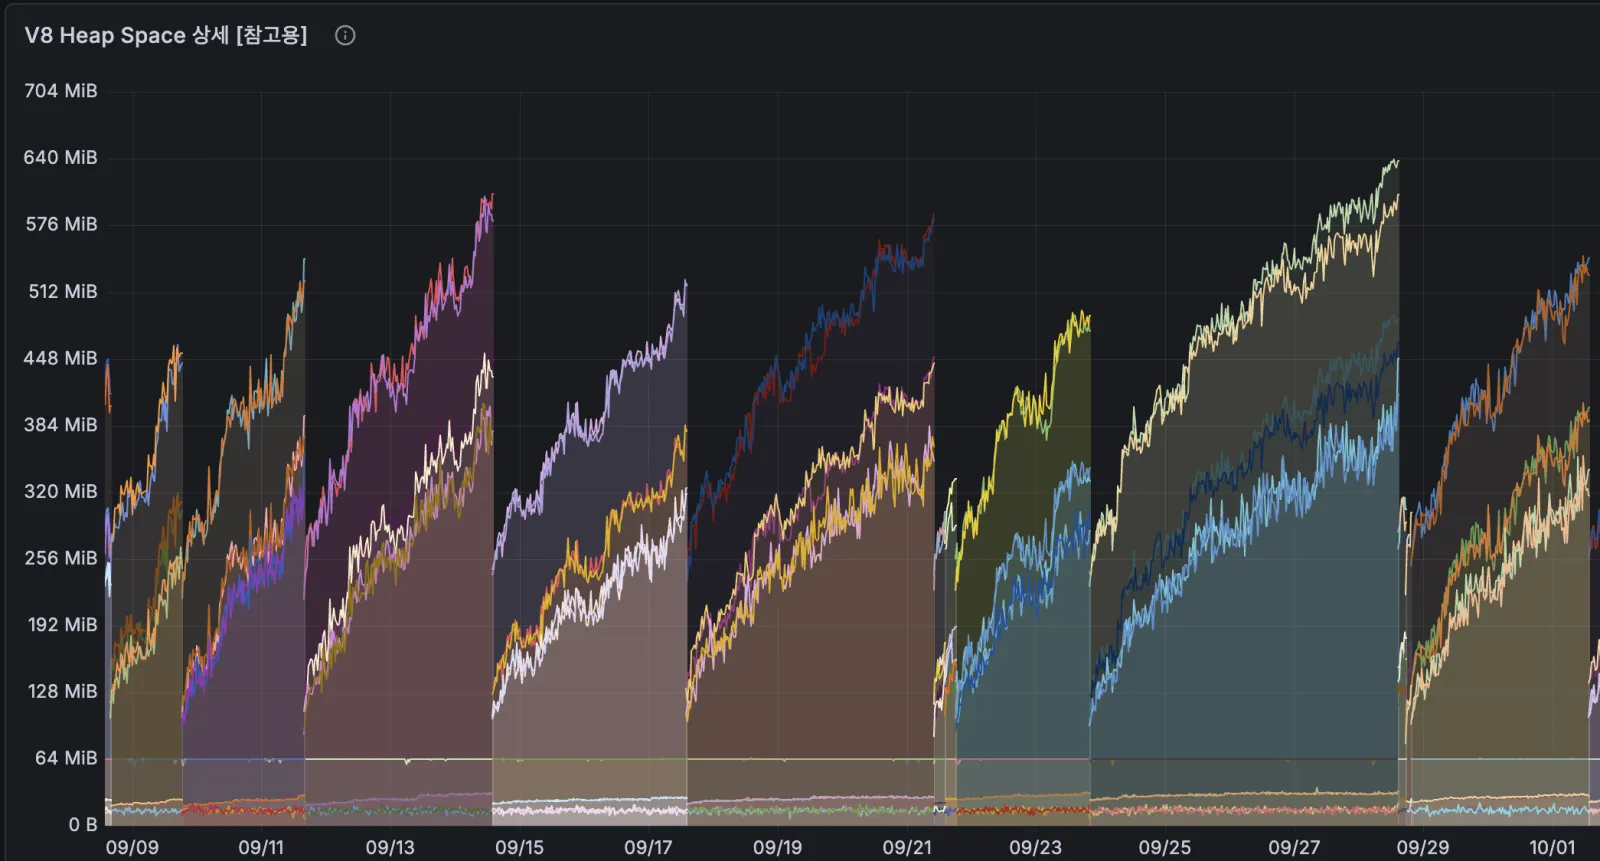
회사의 Next.js 서버는 Kubernetes 파드 안의 컨테이너에서 돌아갑니다. Grafana로 메모리를 모니터링하면 파드가 새로 뜬 뒤 교체될 때까지 메모리 선이 계속 올라가는 게 보였어요. 배포가 잦아서 파드가 자주 바뀌었고, 그때마다 선이 다시 내려와 크게 드러나지 않았습니다. 그래프에서 이상을 보고, 코드에서 원인을 찾고, 고친 뒤 다시 그래프로 확인하는 일을 두 번 했어요.
#clone은 했는데 원본은 아무도 안 읽었다
API 응답을 검사하는 공용 함수가 응답을 clone()한 뒤 복제본만 읽고 있었습니다.
const clonedRes = res.clone();
const data = await clonedRes.json();

if (data.return_code !== 0) {
  throw new CustomError(data);
}성공 응답은 API 클라이언트가 원본을 마저 읽었어요. 에러 응답은 여기서 throw되어 원본을 읽는 코드가 없었습니다.
읽지 않은 body는 GC가 치울 때까지 메모리에 남습니다. Node의 fetch를 만든 undici도 문서에서 body는 꼭 읽거나 취소하라고 적어 두었어요.
로컬에서 운영과 같은 Node 버전으로 8KB짜리 에러 응답 2만 건을 흘려 봤습니다. Node의 메모리는 몇 칸으로 나눠 볼 수 있어요.
GC를 강제로 돌리면 회수되긴 했지만 그 전까지 메모리를 크게 출렁이게 했어요. 에러 경로에서 body를 취소하도록 고쳐 배포했습니다.
#GC를 돌렸더니 파드가 재시작됐다
배포 뒤에도 Grafana의 메모리 선은 계속 올랐습니다. 대시보드에는 컨테이너 메모리 하나만 있어서 그 안에서 무엇이 늘어나는지 알 수 없었어요. 그래서 운영 파드 안의 Node 프로세스에 직접 붙었습니다. Node는 SIGUSR1 신호를 받으면 재시작 없이 디버거(inspector)를 열어요.
external은 38MiB로 clone 쪽은 정리돼 있었고, heapUsed가 373MiB였습니다. 이게 곧 치워질 쓰레기인지 누가 붙잡고 있는 객체인지 보려고 GC를 강제로 돌렸어요.
GC는 정리하는 동안 프로그램을 잠깐 멈춥니다. 힙 전체를 한 번에 정리하라고 시키면 몇 초씩 멈출 수 있어요.
Kubernetes는 liveness probe로 컨테이너가 살아 있는지 계속 물어봅니다. 몇 초 동안 대답이 없자 컨테이너가 죽었다고 보고 재시작했어요. 그 사이 5xx 에러가 79건 났고, 파드가 두 개라 서비스는 계속 돌았습니다.
다시 붙어서 읽은 메모리는 688MiB에서 228MiB로 줄어 있었고, 저는 GC가 치웠다고 적었어요. Kubernetes 기록을 보니 이전 프로세스는 11:05:39에 끝났고 새 프로세스가 11:05:40에 떠 있었습니다. 228MiB는 그 재시작 뒤에 읽은 숫자였어요. 그 뒤로 운영 파드에서는 멈추지 않는 읽기만 합니다.
그때 하나 더 본 게 있습니다. TanStack Query가 데이터를 담아 두는 캐시인 QueryClient가 모듈 스코프 싱글톤이었어요. 앱 전체가 인스턴스 하나를 같이 쓰는 구조입니다. 메모리 쪽은 안 쓰는 캐시가 5분이면 지워지니 원인이 아니라고 판단했어요.
#QueryClient 하나를 모든 요청이 같이 쓰고 있었다
9월 QA에서 로그인하지 않은 요청에 다른 사용자의 데이터가 보이는 문제가 잡혔습니다. 새 화면들이 서버에서 데이터를 미리 받아 그 캐시에 넣기 시작한 뒤였어요. 원인은 7월에 봤던 그 싱글톤이었어요. 서버에서는 요청마다 새 QueryClient를 만들고 브라우저에서만 싱글톤을 쓰도록 고쳤습니다.
let browserQueryClient: QueryClient | undefined;

export const getQueryClient = () => {
  if (typeof window === 'undefined') {
    return createQueryClient();
  }

  browserQueryClient ??= createQueryClient();

  return browserQueryClient;
};
이 수정은 기능 브랜치에 들어가 10월 2일 배포 때 운영에 나갔습니다.
10월 1일에 인프라 엔지니어 팀원인 Scott이 Grafana에서 힙 메모리를 공간별로 나눠 보다가 old space 선을 짚어 주셨어요. V8은 새로 만든 객체를 new space에 두고, 오래 살아남은 객체를 old space로 옮깁니다. old space는 가끔 오는 큰 청소인 major GC 때 정리돼요.
old space는 major GC 뒤에도 바닥이 계속 올라가고 있었습니다. 이 공간별 사용량은 prom-client 기본 지표인 nodejs_heap_space_size_used_bytes로 볼 수 있어요. 다음 날 배포 뒤 그래프는 이렇게 바뀌었습니다.
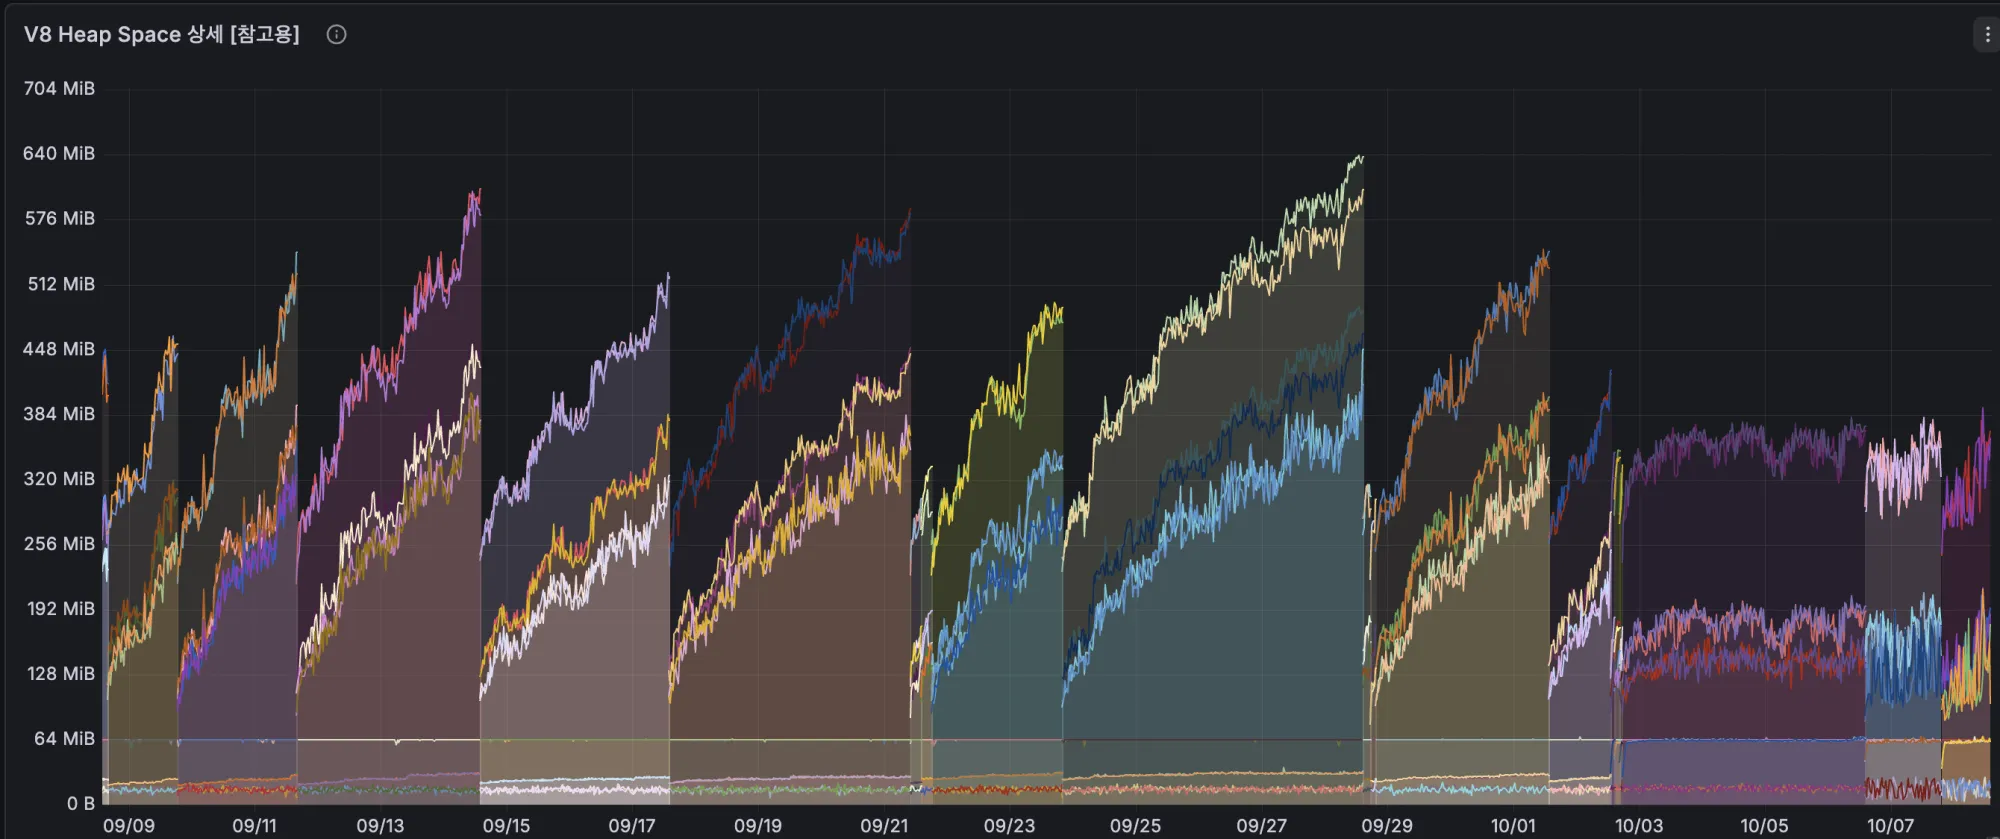
배포 전에는 파드가 교체될 때까지 선이 올라 640MiB 가까이 갔고, 배포 뒤로는 일정한 폭 안에서만 움직여요. 같은 배포에 다른 변경도 실렸지만 old space가 멈춘 건 이 배포부터였고, 팀원도 힙 누수는 잡힌 것 같다고 확인해 주셨습니다.
7월에 저는 이 코드를 브라우저 기준으로 읽었습니다. 파일 맨 위에 'use client'가 있었고, 안 쓰는 캐시가 5분 뒤 지워진다는 것도 브라우저의 기본값이었어요. 같은 코드가 서버에서는 다르게 동작합니다.
TanStack Query의 SSR 문서를 보면 서버에서는 캐시를 지우는 시간인 gcTime이 기본으로 Infinity예요. 같은 싱글톤이 브라우저에서는 한 사람이 쓰다 탭을 닫으면 사라지지만 서버에서는 모든 사람이 같이 쓰고 프로세스가 끝날 때까지 남습니다. 9월의 데이터 노출은 같이 쓰는 데서 나왔고, old space 그래프는 끝까지 남는다는 쪽과 맞아떨어졌어요.
'use client'가 붙은 파일도 서버 렌더링 때 실행됩니다. 그래서 그 안의 전역 값은 누구와 같이 쓰는지, 언제 사라지는지를 서버 기준으로 따로 봐야 했어요. 같은 기준으로 다른 전역 스토어와 쿠키 객체도 확인했고, 둘은 서버에서 값을 쓰는 코드가 없어 그대로 두었습니다.